Перчатка вместо кода: как Reward AI учит роботов за 30 минут

Пока большинство разработчиков пытаются прописать роботам каждое движение через сложные алгоритмы или заставляют операторов часами сидеть в VR-шлемах, стартап Reward AI решил пойти по пути наименьшего сопротивления. Они создали систему, где машина просто «смотрит» на движения человека и копирует их. Главным инструментом в этом процессе стала перчатка Omnibody Hand.
Железо для считывания реальности
Omnibody Hand — это не просто очередной манипулятор, а насыщенное сенсорами устройство для сбора данных. Она оснащена тактильными датчиками, сенсорами приближения и камерами с глобальным затвором. Такой набор позволяет фиксировать не только траекторию движения руки, но и мельчайшие детали взаимодействия с объектами: от момента приближения до силы и характера захвата.
Для точного отслеживания положения в пространстве разработчики Reward AI объединили визуально-инерциальную систему с электромагнитным позиционированием. Такое комбо оказалось эффективным: во время тестов на высоких скоростях средняя ошибка миграции заданной точки сократилась на 60%. Это критически важно, когда речь идет о деликатных манипуляциях, где лишний сантиметр может означать разбитый стакан или испорченную деталь.
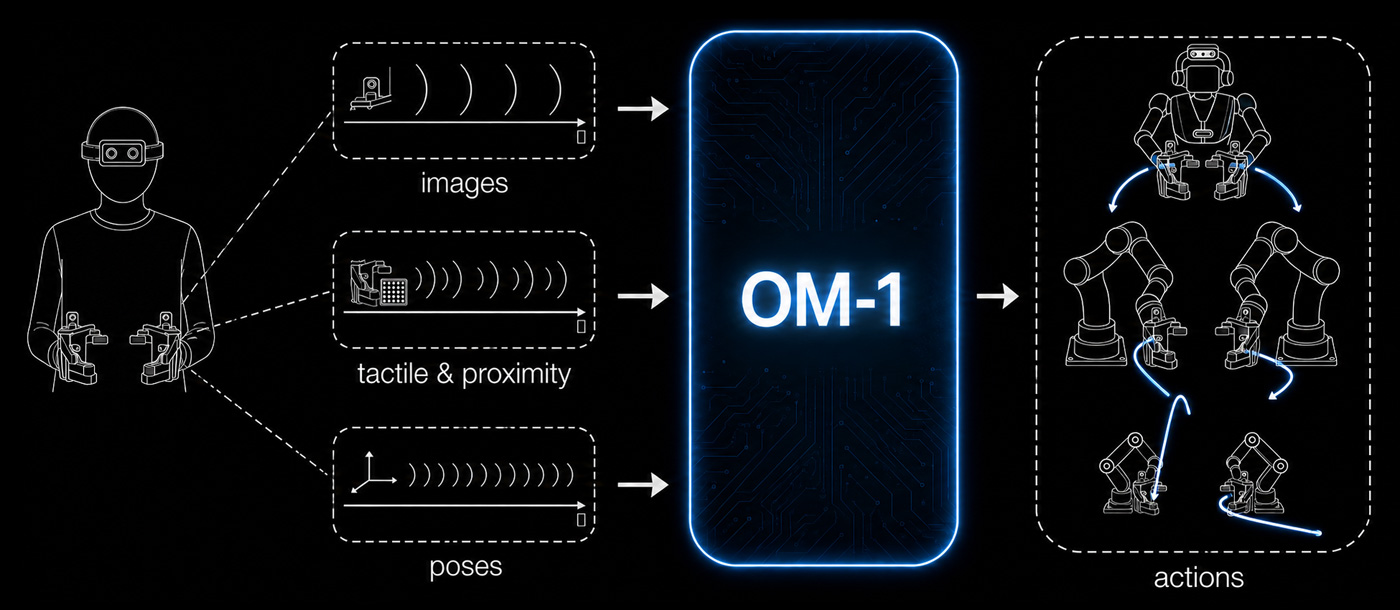
OM-1 обрабатывает мультимодальные сенсорные потоки, полученные с помощью системы Omnibody Hand, и генерирует действия со скоростью, свойственной человеку, для различных роботизированных тел. Иллюстрация: Reward AI
Модель OM-1: обучение без посредников
Все собранные данные поступают в OM-1 — универсальную модель управления. Ее фишка в том, что она учится непосредственно на демонстрациях человека. Здесь нет необходимости в телеприсутствии или предварительном «дрессировке» на конкретном железе. Модель поглощает изображения, тактильные сигналы, данные о расстоянии между пальцами и траекторию руки.
На выходе OM-1 выдает четкие параметры: направление, скорость движения, силу и моменты ключевых событий. По заявлению компании, для освоения нового задания, включая сложные контактные действия и длинные последовательности движений, системе требуется менее 30 минут записей. В мире обучения роботов через имитацию это почти мгновенно.
Автономность и адаптивность
Непосредственным выполнением команд занимается отдельный уровень управления, который предварительно обучили с подкреплением в симуляции. Он работает на высокой частоте независимо от скорости работы основной модели OM-1. Это позволяет сглаживать переходы между действиями и компенсировать задержки или внешние помехи. Главное преимущество такого подхода — универсальность: изученные навыки можно переносить между различными роботизированными платформами без необходимости переобучения модели под каждый новый манипулятор.
Пока индустрия спорит о том, заменит ли ИИ программистов, Reward AI наглядно показывает, что он вполне может заменить сложные инструкции простой демонстрацией «делай как я».
Пока одни учат роботов двигаться, другие оптимизируют железо для их мозга. Так, Samsung избавляется от DDR5, передавая производство на аутсорс, чтобы полностью сосредоточиться на решениях для искусственного интеллекта.
Подписывайтесь на наш нескучный канал в Telegram, чтобы ничего не пропустить.


